

AIクローラーのアクセスが増えていますが、全部ブロックしてよいのでしょうか。GPTBotやOAI-SearchBot、ClaudeBotなどをログで見かける機会が増え、負荷やコンテンツ取得を気にして遮断したくなる場面もあります。ただ、同じ「AIクローラー」でも役割は同じではなく、止め方を間違えると検索や参照の機会まで失う可能性があります。
Cloudflareが公開した2025年のデータでは、Googlebotを除くAIボットがHTMLリクエストの平均4.2%を占め、ユーザー操作をきっかけにWebページを取得するタイプのクロールも大きく増えています。AkamaiもAIボットトラフィックの増加を報告しており、AIクローラーはすでにWebサイト運用で無視しにくいトラフィックになってきました。
AIクローラーは全部同じではない
「AIからコンテンツを取りに来るなら、まとめて止めた方が安全では?」と思うかもしれません。ところが、AI事業者が使うクローラーは検索・参照・学習など用途が分かれており、同じ会社のクローラーでも役割が違います。サイト運用では、AIかどうかだけでなく、何のためにアクセスしているのかを見る必要があります。
検索と学習では役割が違う
OpenAIを例にすると、OAI-SearchBotはChatGPT検索でWebサイトの内容を発見・表示するために使われます。GPTBotはモデル改善や学習用途に関係するクローラーとして扱われています。学習用途には使わせたくないが、ChatGPT検索から自社サイトを見つけてもらうことは許可したい、というサイトなら両者を同じルールにする必要はありません。
GoogleにもGoogle-Extendedがあり、Google検索への掲載とは別にGemini関連での利用を制御できます。ざっくり「AIなら全部BLOCK」としてしまうと、本来残したかった検索・参照経路まで閉じることがあります。
正規クローラーでも多すぎれば負荷になる
正規のAIクローラーでも、短時間に大量のページを巡回すればオリジンサーバーへの負荷になります。ページ数の多いサイトでは、人間のユーザーよりクローラーの方が連続して多くのURLへアクセスすることもあります。
この場合はALLOWかBLOCKかの二択ではなく、正規クローラーなら通常時は許可し、アクセスが集中したときだけRATE LIMITをかける方法があります。CDNを利用している場合、キャッシュHITする静的コンテンツと、検索ページなどキャッシュしにくい動的コンテンツでは同じリクエスト数でも負荷が違います。リクエスト数だけで機械的に決めると、少しもったいない制御になることがあります。
正規クローラーをどう見分けるか
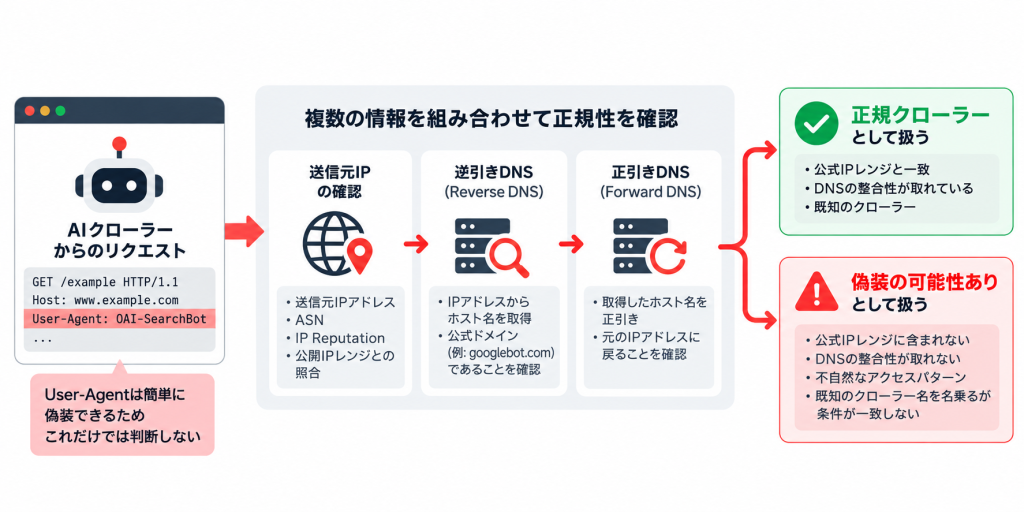
クローラー制御で最初に目に入るのはUser-Agentです。ログにGooglebotやOAI-SearchBotと書かれていれば分かりやすいのですが、User-Agentは送信側が自由に変更できます。そのため、名前だけを見て無条件にALLOWするのではなく、送信元IPやDNSなど別の情報と組み合わせて確認します。
User-Agentだけで許可しない
不正なスクレイパーが Googlebot や OAI-SearchBot を名乗ること自体は難しくありません。Googleも、Googlebotを名乗るアクセスが本当にGoogleから来ているかを確認する方法を案内しています。有名なクローラー名だから安全、とは言い切れないわけです。
公開IPレンジやDNSを組み合わせる
Googleは、送信元IPアドレスの逆引きDNS、または公開IPレンジとの照合による確認方法を案内しています。逆引きを使う場合は、得られたホスト名がGoogle管理ドメインであることを見るだけではなく、そのホスト名を再度正引きし、元のIPアドレスへ戻ることまで確認します。Bingも同じように *.search.msn.com の確認と正引きを組み合わせる方法を案内しています。
OpenAIもOAI-SearchBotなどで利用できるIPリストを公開しています。実際のWAFやCDNでは、User-Agentに送信元IP、公式IPリスト、DNS確認を重ねた方が扱いやすいでしょう。OAI-SearchBotを名乗っているのに公開IPレンジと一致しないなら、正規クローラーと同じ扱いにしない、という判断ができます。
GEOIPだけではクローラーの正体は分からない
国内向けサービスでは、海外からのアクセスをGEOIPで制限することがあります。攻撃面を狭める用途では有効な場面がありますが、クローラーの真正性確認とは別の話です。
日本のユーザーがChatGPTで検索していても、Webサイトへアクセスするクローラーが日本国内のIPから来るとは限りません。逆に、不正Botが日本国内のクラウドやProxyを使うこともあります。「日本IPなら正規、海外IPなら不正」という判定にはできません(もちろん、サービス方針として国単位でアクセスを制限するのは別です)。
IPリストやDNS確認は毎回行わない
ここまで確認項目を増やすと、リクエストごとに逆引きDNSを実行したり、各社のIPリストを取得したりするのは現実的ではありません。実運用では、公式IPリストを定期取得してローカルへ保持し、DNSの確認結果も一定時間キャッシュする構成が扱いやすくなります。
CDNやWAFのエッジ側では、アクセスを受けた時点で手元の情報から判定できるようにしておく方がよいでしょう。外部サービスへの問い合わせをリクエスト処理の途中へ入れると、クローラー判定そのものが新しいボトルネックになりかねません。
正規性だけでなく「どう動いているか」も見る
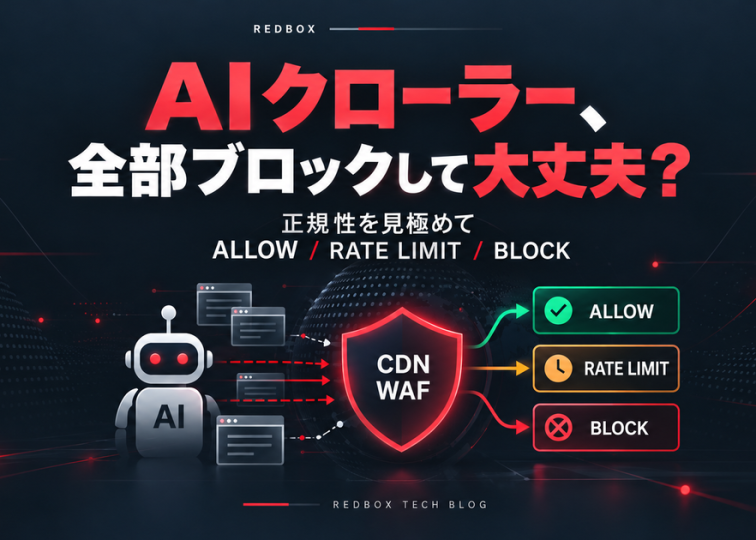
すべてのAI事業者が固定IPリストを公開しているわけではなく、IPだけで完全に確認できないケースもあります。そこで、正規か不正かの2種類だけに分けず、公式情報で確認できたクローラー、既知だが完全には検証できないクローラー、有名なクローラーを名乗っているのに確認できないアクセス、その他の自動通信、と段階を持たせる方が運用しやすくなります。
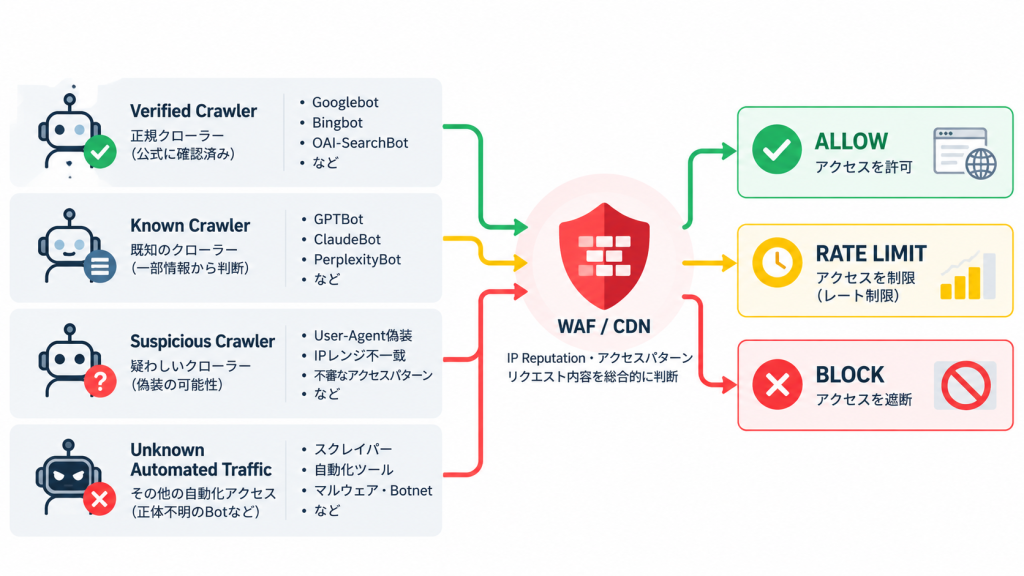
この図のように、真正性だけでなくアクセス頻度、URLの巡回パターン、HTTPヘッダー、IP Reputationなども判断材料にできます。正規性が確認できて通常の範囲ならALLOW、正規でも過剰ならRATE LIMIT、偽装や明らかな不正アクセスならBLOCKという考え方です。
ただし、判定条件を増やせば増やすほど良いわけでもありません。ルールを細かくしすぎると、正規クローラーの仕様変更に追従する手間や誤検知の確認も増えます。運用できる範囲で段階を持たせるのが現実的だと思います。
AI時代はBotを止めるより、まず識別する
従来のBot対策は「悪いBotをどう止めるか」が中心でした。しかし、AI検索やAIアシスタントが普及すると、正規クローラーまで一律に止めることで検索やAIサービスから自社サイトを発見してもらう機会まで失う可能性があります。逆にすべて許可すれば、大量クロールやUser-Agentを偽装したスクレイパーまで通してしまいます。
CDNはオリジンサーバーより前で通信を受けるため、クローラーの判定やレート制御を行う場所として相性がよく、WAFやIP Reputationと組み合わせればアクセス元とリクエスト内容の両方を見られます。AIからのアクセスが増えるほど、「AIを止めるか」より「どのAIを、どの条件で通すか」を決められることの方が重要になっていくのではないでしょうか。
 相次ぐ不正アクセス、攻撃はどこから始まる? 脆弱性スキャンとWAF・IP Reputationで考える入口対策
 CDNとWAFが選ばれる理由(セキュリティ対策)
 CDN 料金 一覧2017年(高いCDNと安いCDNの違い)
 CDN とCNAME Apexドメインの制限